
Pythonで学ぶコンピュータビジョン
Python、OpenCV、EasyOCRを使ったコンピュータビジョンとナンバープレート認識の入門。
はじめに
今回はPythonでコンピュータビジョンを少し試し、ANPR(ナンバープレート自動認識)などへの応用を見ていきます。この分野は幅広く、私自身もあまり取り組んだことがないため、ごく基本的な紹介になります。この記事を通じて、皆さんと一緒に何か学べればと思います。
今後の記事では、比較的簡単なCAPTCHAを自動で解くことにも応用してみたいです。以前試したことはありますが、各段階を詳しく調べずに進めたので、改めて取り組むと面白そうです。
それでは始めましょう。
コンピュータビジョンとは?
大まかに言うと、人間の視覚をコンピュータで模倣するための技術や手法です。アルゴリズムが画像から情報を取り出し、それを処理して、結果に応じた動作を行います。
今回の簡単な実演では、Pythonといくつかのライブラリを使います。特にOpenCVは、コンピュータビジョンに役立つ多くの関数を提供しています。
OCR
OCR(光学文字認識)は、画像から文字を取り出す処理です。大きく次の段階に分けられます。
- 二値化: 画像を白と黒に変換します。多くのアルゴリズムは2色だけの二値画像を扱います。OpenCVも例外ではありません。
- 行と単語の分割: 単語を一つずつ切り分けます。
- 文字認識とパターン照合: 取り出した文字をデータベースと比較します。参照データの質が高いほど、良い結果が得られます。
幸い、TesseractやEasyOCRといったライブラリには、文字を認識するモデルがすでに用意されています。
今回はEasyOCRを使います。この例では、数字の認識でTesseractより良い結果が得られました。
前処理や後処理も追加できます。画像のノイズ除去、パラメータの正規化、出力への制約などです。たとえば、今回対象にするスペインの形式では、152L PLQという結果は正しいナンバープレートではないと判断できます。
ナンバープレートが見える車の画像を探します。今回はスペインのプレートを付けた赤いSeat Ibizaです。プレートがはっきり見える、鮮明で構図の良い画像をあえて選びました。交通カメラの映像がいつもこれほど好条件とは限りませんが、仕組みの実演には十分です。
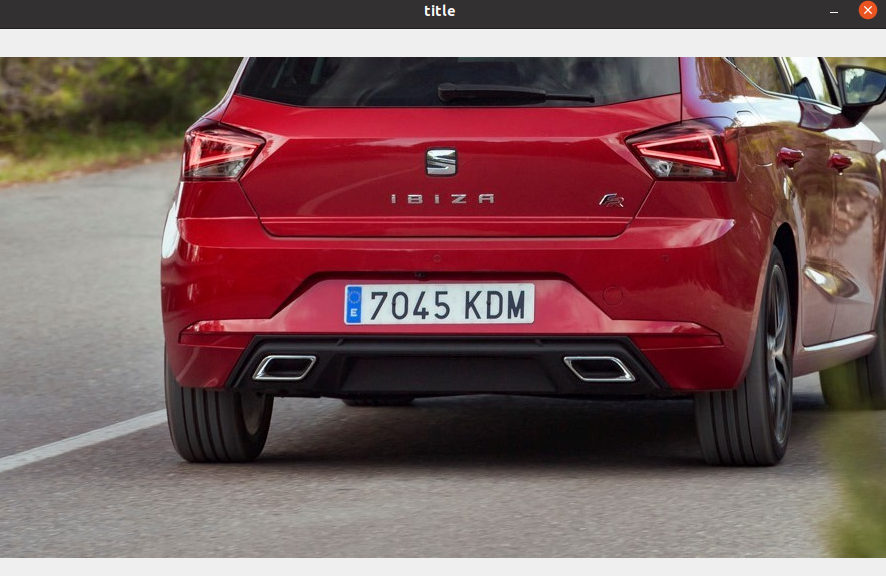
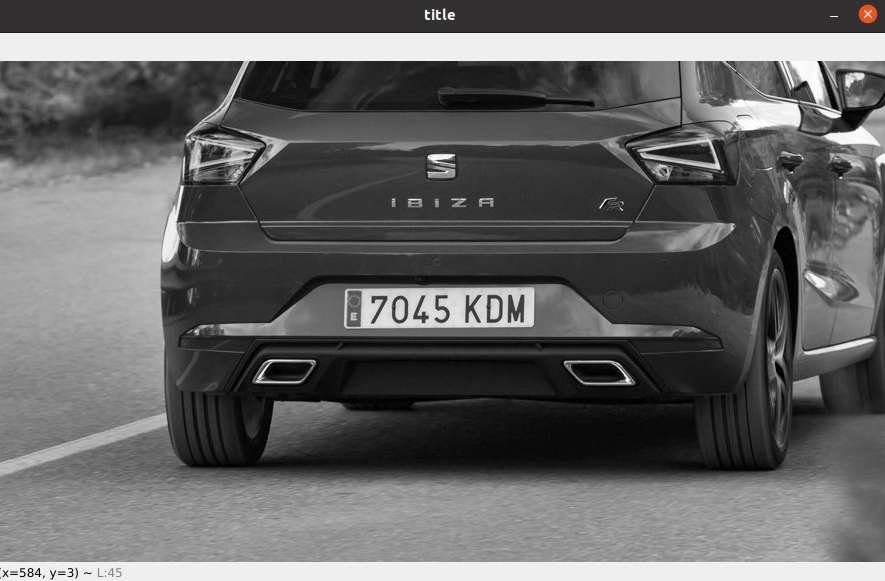
OCRの手順で説明したように、まず画像を白黒に変換します。

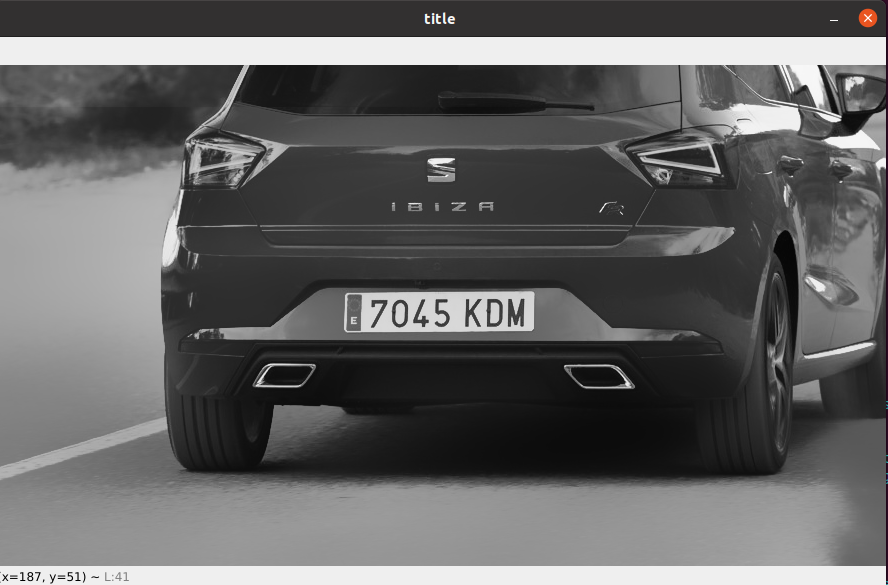
次に画像のノイズを減らし、プレートをより鮮明にして後の処理を容易にします。

続いてCannyアルゴリズムで画像のエッジを取り出し、ほかの画素から分離します。これにより、画像内の図形を探しやすくなります。

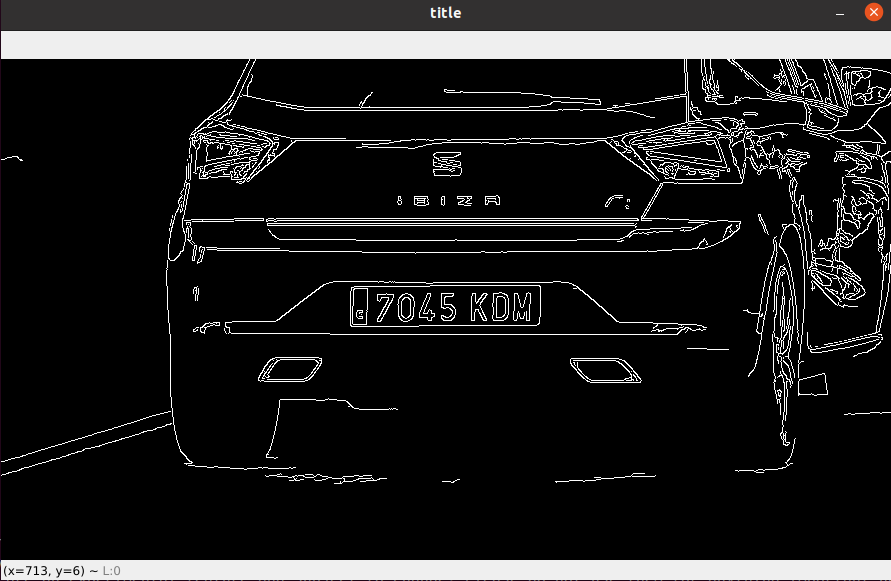
輪郭が得られたら、大きい順に並べ、最初に見つかる四辺形を探します。その長方形や正方形が、うまくいけばナンバープレートです。
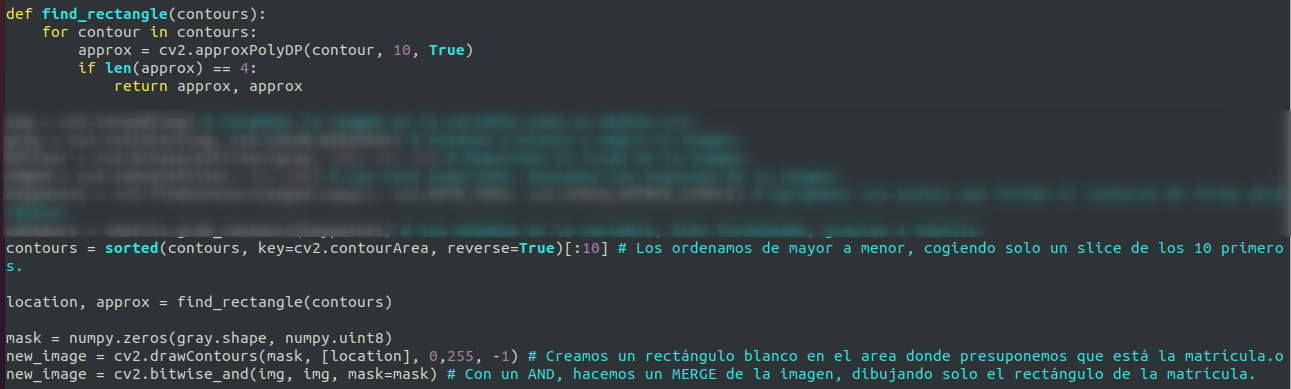
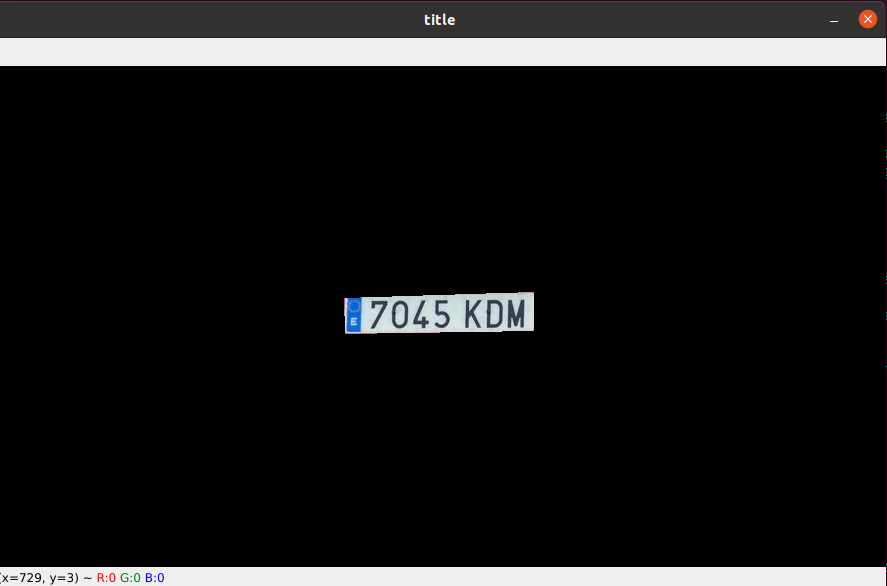
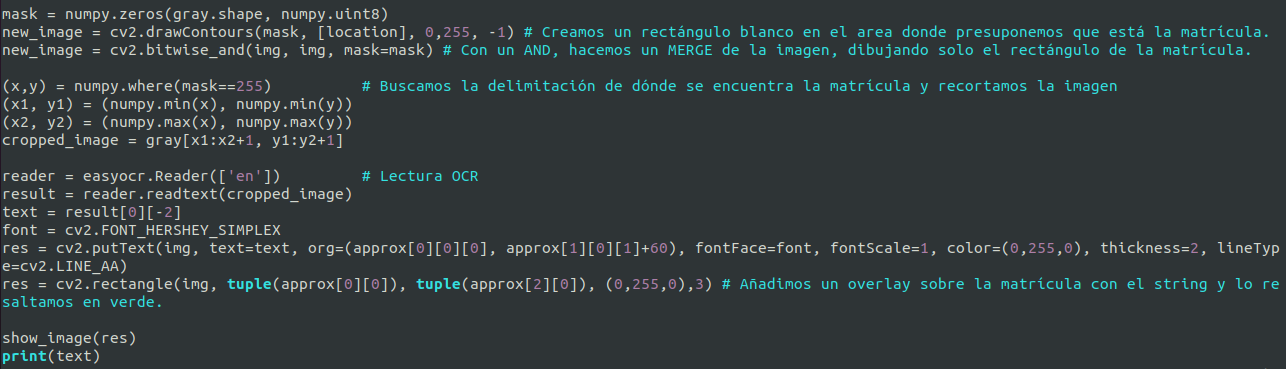
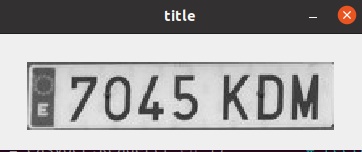
次に、その四角形だけを切り抜いた画像を作り、OCRエンジンに渡します。ここではEasyOCRを使いますが、Tesseractでも同じ結果が得られる場合があります。
プレートを読み取ったら、その領域を緑色の枠で囲み、認識した番号を横に表示します。
問題点
画像に番号が表示され、コンソールにも文字列が出力されるので、ひとまず動作しました。ただし、別の画像では失敗することがあります。プレートが最大の四辺形とは限らず、別の領域を選んで誤った画像をOCRに渡す可能性があります。また、この方法は一つのプレートしか選ばないため、複数のプレートが写った画像にも対応できません。
おわりに
この例から、コンピュータビジョンの応用範囲の広さを感じてもらえれば幸いです。今後はさらに掘り下げて、今回の問題に対する別の手法や解決策も試したいと思います。