
Компьютерное зрение на Python
Введение в компьютерное зрение и распознавание автомобильных номеров с помощью Python, OpenCV и EasyOCR.
Введение
Сегодня мы немного познакомимся с компьютерным зрением на Python и его применением, например с ANPR — автоматическим распознаванием автомобильных номеров. Это будет довольно простое введение: тема обширная, а я пока мало работал в этой области. Надеюсь, эта статья позволит всем нам узнать что-то новое.
В одной из следующих статей я хотел бы применить эти методы для автоматического решения достаточно простых CAPTCHA. Когда-то я уже делал это, но не разбирал каждый шаг подробно, а ведь это может быть интересно.
Приступим.
Что такое компьютерное зрение?
В общих чертах, компьютерное зрение — это методы, позволяющие компьютеру имитировать наше зрение. Алгоритмы извлекают информацию из изображений, обрабатывают её и действуют на основе результатов.
Для небольшой демонстрации мы используем Python и несколько библиотек, прежде всего OpenCV, которая предоставляет множество функций для компьютерного зрения.
OCR
Оптическое распознавание символов, или OCR, позволяет извлекать текст из изображения. Этот процесс можно разделить на следующие этапы:
- Бинаризация: преобразование изображения в чёрно-белое. Многие алгоритмы работают с бинарными изображениями, содержащими только два цвета; OpenCV не исключение.
- Сегментация строк и слов: выделение отдельных слов.
- Распознавание символов и сопоставление с образцами: сравнение извлечённых символов с базой данных. Чем качественнее эталонные данные, тем лучше результат.
К счастью, такие библиотеки, как Tesseract и EasyOCR, уже предоставляют модели для распознавания текста.
Мы будем использовать EasyOCR: в этом примере он распознавал цифры лучше, чем Tesseract.
Также можно добавить предварительную и последующую обработку: убрать шум, нормализовать параметры или ограничить допустимый результат. Например, мы знаем, что 152L PLQ не соответствует испанскому формату номеров, с которым мы работаем.
Найдём изображение автомобиля с видимым номером: красный Seat Ibiza с испанским номерным знаком. Мы специально выбрали чёткую фотографию с хорошим ракурсом и хорошо читаемым номером. Кадр с дорожной камеры не всегда будет настолько удачным, но для демонстрации эта фотография подойдёт.
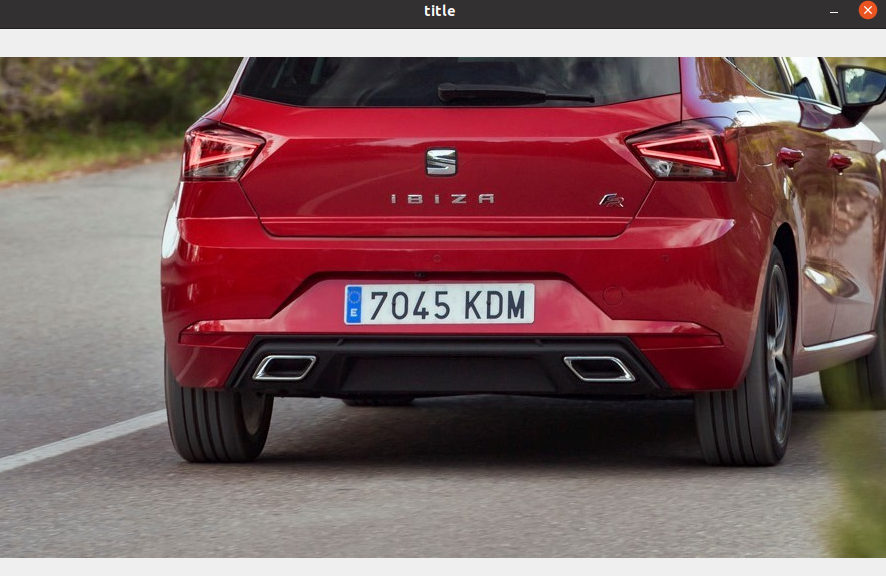
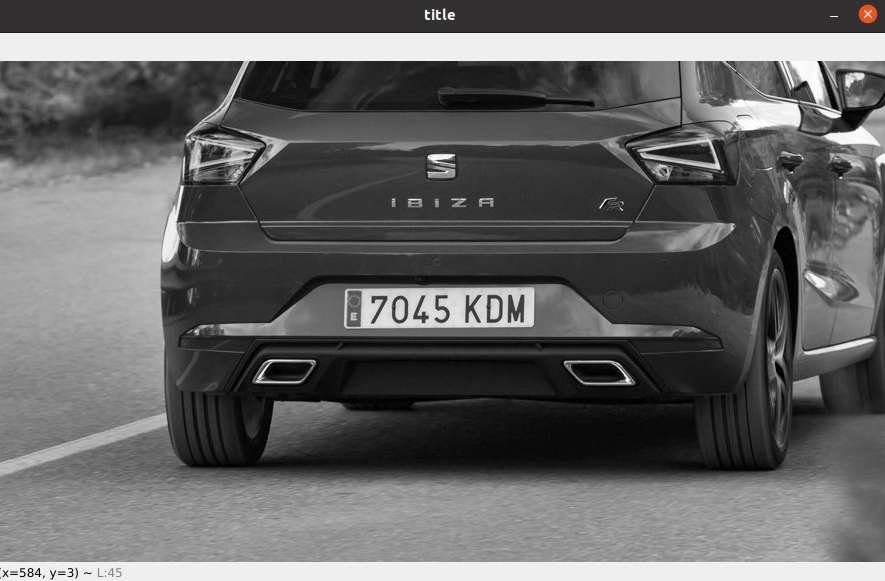
Как уже говорилось в описании этапов OCR, сначала нужно преобразовать изображение в чёрно-белое.

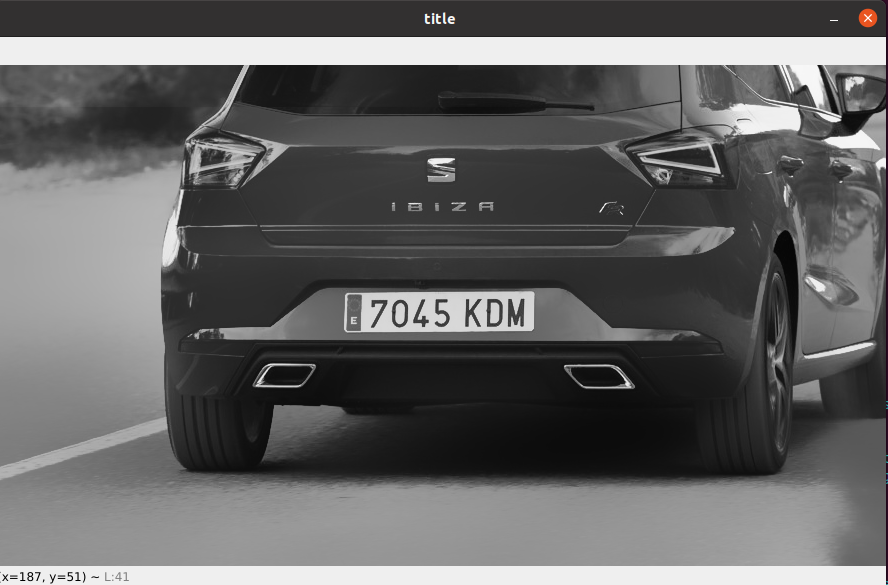
Затем уменьшаем шум, чтобы номер стал чётче и его было проще обработать.

Теперь применяем алгоритм Кэнни, чтобы выделить границы объектов и отделить их от остальных пикселей. Это упростит поиск фигур на изображении.

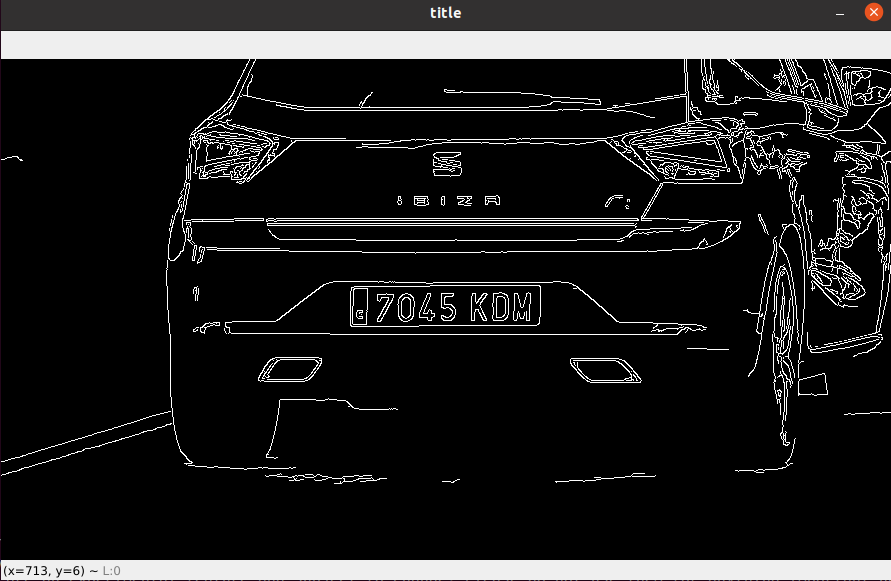
Полученные контуры сортируем от большего к меньшему и ищем первый с четырьмя сторонами: прямоугольник или квадрат, который, будем надеяться, окажется нашим номером.
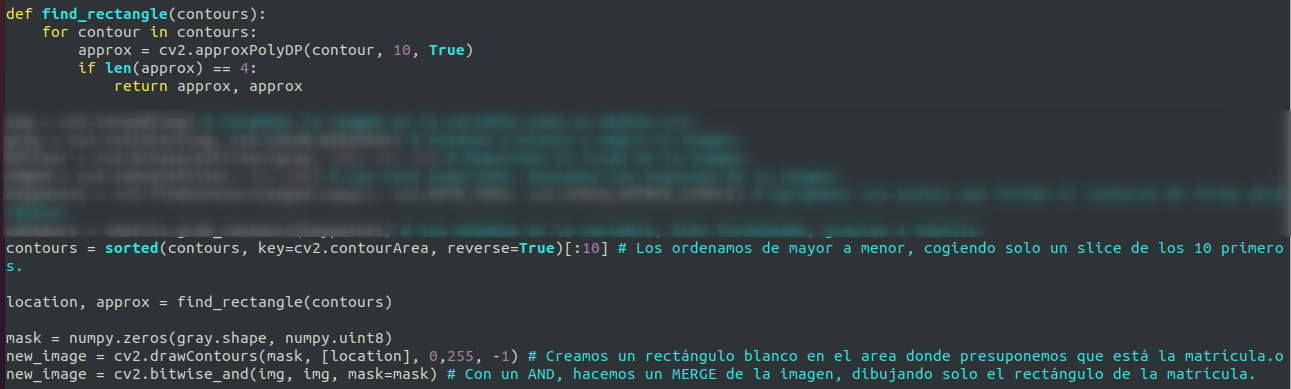
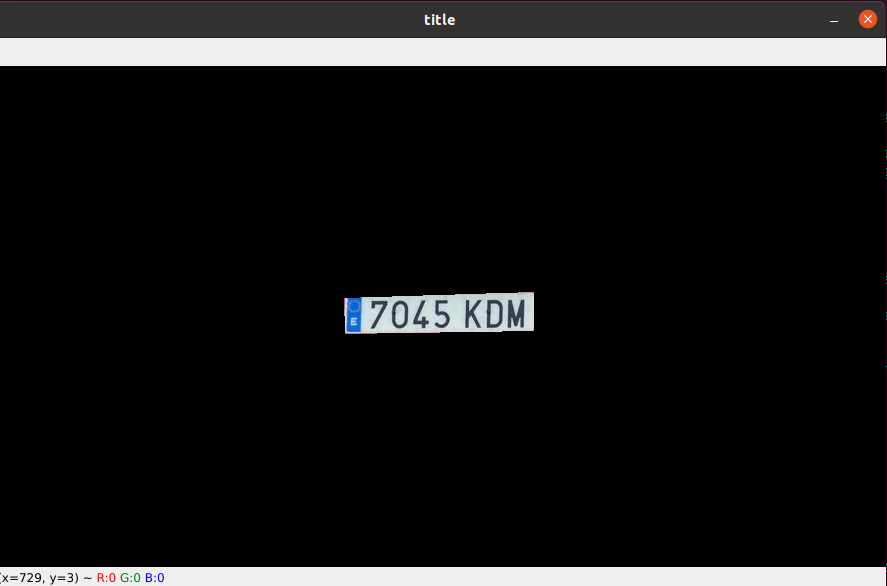
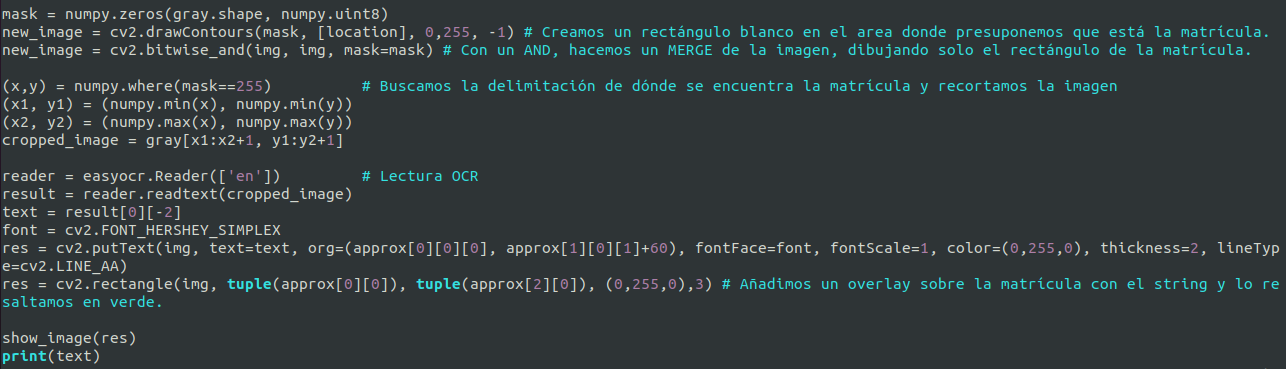
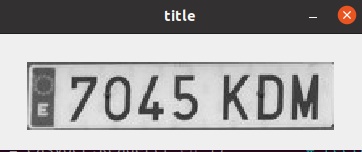
Затем создаём новое изображение, содержащее только вырезанный прямоугольник, и передаём его OCR. Здесь используется EasyOCR, хотя Tesseract тоже мог бы дать такой же результат.
Распознав номер, выделяем его прямоугольник зелёным и выводим рядом распознанный текст.
Проблемы
Всё работает: номер отображается на изображении и в виде строки в консоли. Но с другими изображениями возможны ошибки. Номер не всегда будет самой большой четырёхугольной фигурой, поэтому программа может выбрать другую область и передать OCR неправильное изображение. Несколько номеров на одном снимке тоже создают проблему, поскольку этот подход выбирает только один.
Заключение
Надеюсь, этот пример даёт представление о разнообразии применений компьютерного зрения. В следующих статьях хотелось бы подробнее изучить тему и попробовать другие подходы и решения этой задачи.