
用Python入门计算机视觉
使用Python、OpenCV和EasyOCR入门计算机视觉与车牌识别。
引言
今天我们来了解一下Python中的计算机视觉,以及它在ANPR(自动车牌识别)等任务中的应用。这只是一个基础入门:这个领域很广,我也没有太多相关经验,希望大家能和我一起从这篇文章中学到一些东西。
在后续文章中,我想尝试将它用于自动识别一些比较简单的验证码。我以前做过,但当时没有仔细研究每个步骤,重新探索一下应该会很有意思。
开始吧。
什么是计算机视觉?
简单来说,计算机视觉是一系列让计算机模拟人类视觉的技术和方法。算法从图像中提取信息,对其进行处理,再根据结果采取相应行动。
这次小演示会使用Python和几个库,其中最重要的是OpenCV,它提供了许多计算机视觉相关的函数。
OCR
OCR,即光学字符识别,用于从图像中提取文字。这个过程可以分为以下几个阶段:
- 二值化: 将图像转换为黑白两色。许多算法处理的是只有两种颜色的二值图像,OpenCV也不例外。
- 行与词的分割: 将单词逐个分离出来。
- 字符识别与模式匹配: 将提取出的字符与数据库进行比较。参考数据越好,识别结果通常也越好。
幸运的是,Tesseract和EasyOCR等库已经提供了文字识别模型。
这里使用EasyOCR,因为在这个例子中,它识别数字的效果比Tesseract更好。
还可以增加预处理和后处理,例如去除噪声、归一化某些参数,或对输出施加约束。例如,针对这里使用的西班牙车牌格式,我们知道152L PLQ不是有效的识别结果。
先找一张能看清车牌的车辆照片:一辆挂着西班牙车牌的红色Seat Ibiza。我们特意选了一张清晰、构图合适且车牌非常易读的图片。交通摄像头拍到的画面不一定有这么理想,但这张图片足以演示整个过程。
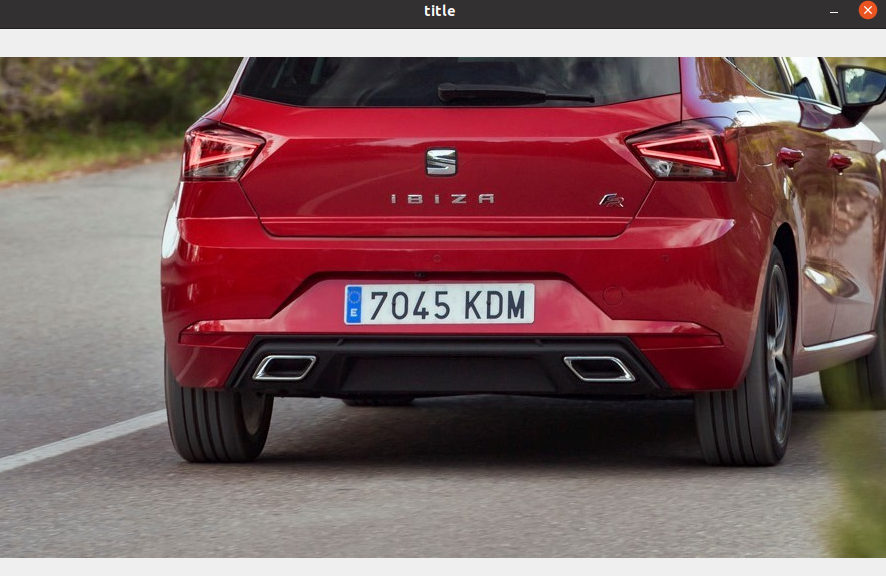
正如OCR步骤中所说,首先需要将图像转成黑白图像。

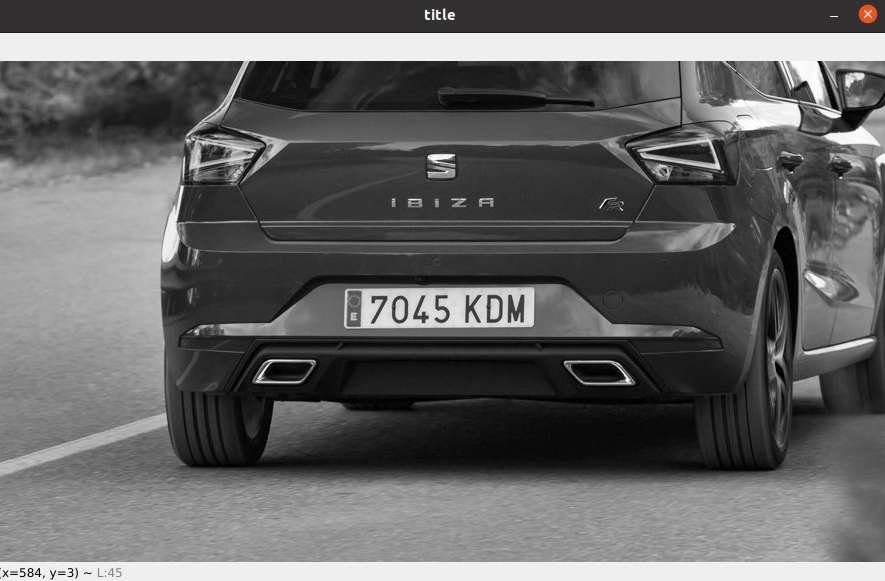
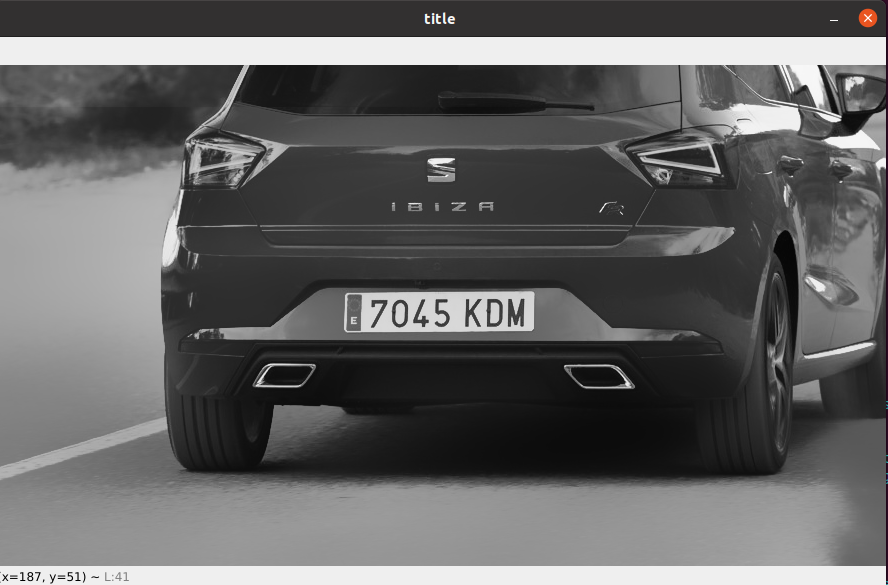
接下来减少图像噪声,让车牌更清晰,方便后续处理。

然后使用Canny算法提取图像边缘,将其与其他像素分离,以便寻找图像中的形状。

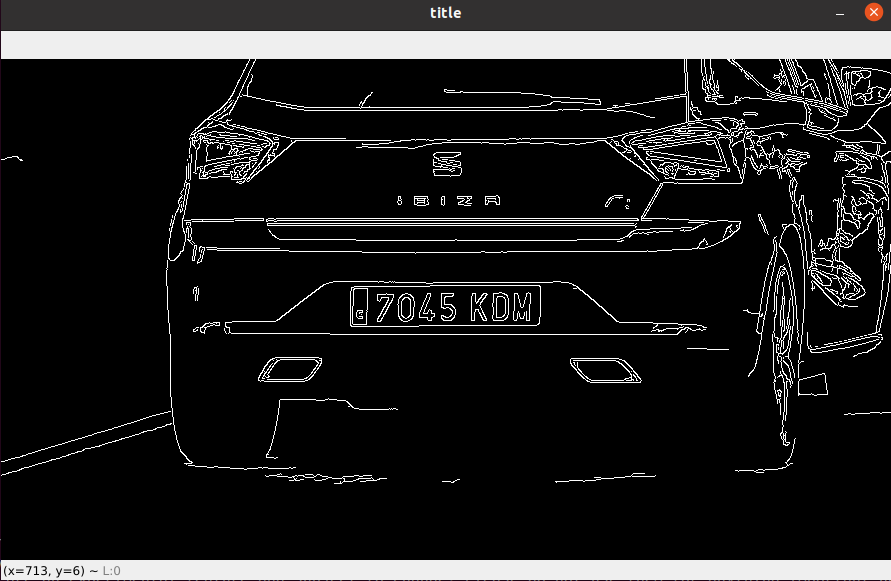
得到轮廓后,按大小降序排列,寻找第一个有四条边的轮廓,也就是一个矩形或正方形,希望它正好是车牌。
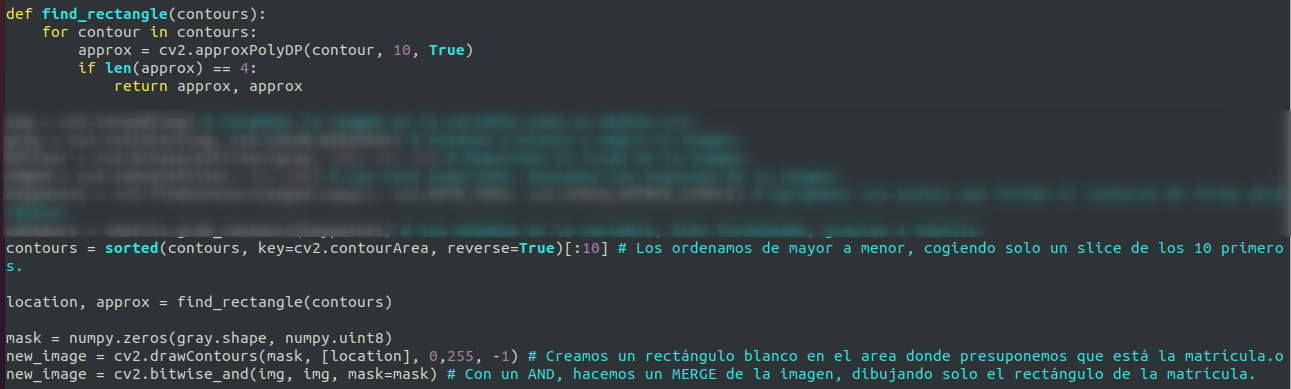
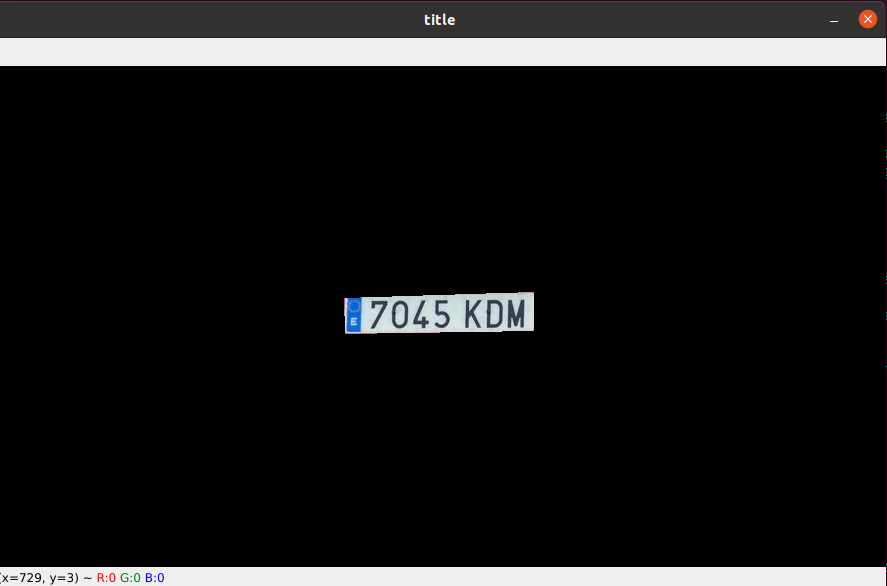
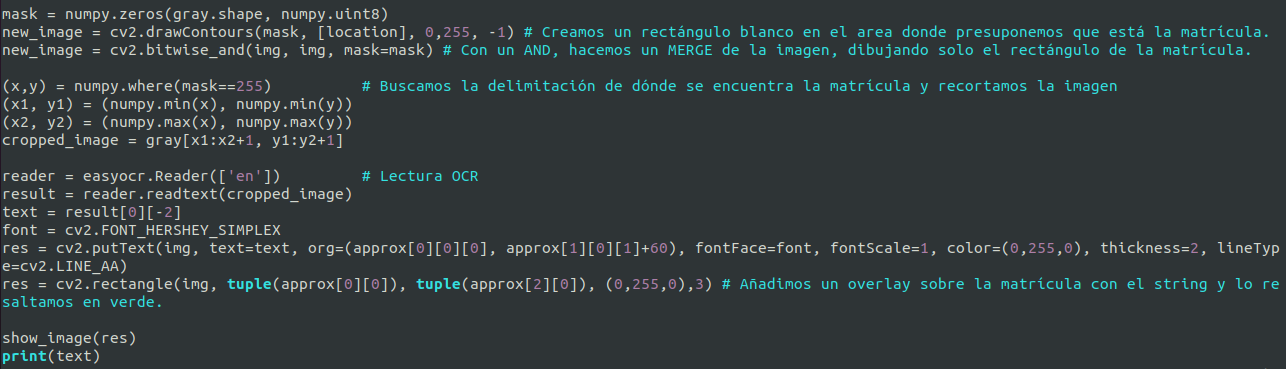
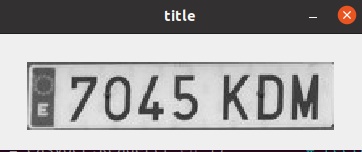
随后创建一张只包含这个裁剪矩形的新图像,并将其交给OCR引擎。这里使用EasyOCR,不过Tesseract也可能得到相同的结果。
读取车牌后,用绿色矩形框标出它的位置,并在旁边写出识别到的号码。
问题
它确实能工作:图片上显示了车牌号码,控制台也输出了对应字符串。但换用其他图片时,可能会失败。车牌不一定是最大的四边形,程序可能选中其他区域,将错误的图像交给OCR。包含多个车牌的图片也会有问题,因为这种方法只选择一个车牌。
结语
希望这个例子能让大家了解计算机视觉的多种用途。在后续文章中,我想继续深入这个主题,尝试解决当前问题的其他思路和方法。